非線形最適化(1) - 最急降下法, Newton法, GN法
初めに
工学の分野で遭遇するモデルの多くは非線形なモデルが殆どで、それらのモデルによって構築される制約条件や最小化したい目的関数も非線形となる。そして、構築したモデルを用いて、条件を満たす若しくは目的関数を最小化するパラメータの推定が行われる。非線形最適化の手法は、それらの場面で活躍する。
非線形のモデルで表される問題を解くためには、それを解くためのソルバーを実装する。しかし、実装を一から構築する必要はなく、オープンソースの非線形ソルバーを使えばよい。問題を解くための道具は既に用意はされている。ただ、全ての問題に対して万能な解法はなく、また十分に性能を高めるには問題の構造に応じて適切な方法・パラメータを選択する必要がある。ソルバーの関数群はコンパクトにまとまっていて、使い易く整備はされているが、それらを正しく使いこなすには非線形最適化についての基本的な理解が必要となる。
本エントリーでは、まず非線形最適化の概要について簡単に述べる。続いて、基本的な手法である最急降下法、Newton法、Gauss-Newton (GN)法についてまとめる。これらの方法について詳細について解説した記事は、優秀な解説が数多く散見される。正確性や具体的な理論の解説はそれらに譲るとして、なるべく感覚的に分かるような説明を目指してまとたいと思う。また、より実用的に用いられているGauss-Newton (GN)法を改良したLevenberg Marquardt(LM)法については少々内容も複雑なので、別のエントリーにてまとめようと思います。
非線形最適化とは
非線形最適化とは、文字通り線形でない関数$f({\bf x})$で表された条件を満たす変数を求める問題である。具体的には、変数${\bf x} \in R ^n$について
$$ f({\bf x})=0 \tag{1}$$
を満たす${\bf x ^ *}$を求めたいとする。この${\bf x ^ *}$を求めるための方法が非線形最適化という分野によって扱われる。非線形最適化にも、さらに制約ありの場合となしの場合に大別される。本エントリーは、基本となる制約なしの場合についてとりあげる。
非線形最適化が必要になる背景として、関数$f({\bf x})$が線形関数である場合の例を最初に確認する。最も単純な具体例として、行列$\bf{A} \in R ^{n \times n}$とベクトル$\bf{b} \in R ^n$を用いて式(2)の様に条件が表される場合を考える。
$${\bf A} {\bf x} - {\bf b} = 0 \tag{2}$$
この時、行列$\bf{A}$が逆行列をもつ、つまり正則であれば条件(2)を満たす$\bf{x ^ *}$は逆行列を使って式(3)のように表すことができる。 $${\bf x ^ *}={\bf A} ^{-1}{\bf b} \tag{3}$$ したがって、条件式に登場する行列${\bf A}$とベクトル${\bf b}$をそのまま使って解析的に${\bf x ^ *}$を求めることが出来る。
世の中の様々な分野で扱う数理モデルは式(2)のような線形なモデルである事は珍しく、非線形である事の方が多い。その場合、式(3)のように解析的に式(1)を厳密に満たす$\bf{x ^ *}$を求めることは困難となる。そこで、解析的に厳密な解を求める代わりに左辺の$f({\bf x})$を最小にする${\bf x}$を求めるということを行う。
$${\bf x ^ *}=\underset{{\bf x} \in R}{argmin} \space f({\bf x}) \tag{4}$$
この最小となる${\bf x}$を求めるための理論を与えてくれるのが非線形最適化という分野である。続いて、非線形最適化について具体的に見ていく。
全体像
制約なしの非線形最適化についてその全体像を確認する。非線形最適化の基本的なアイデアは、微分を使って関数$f({\bf x})$の極小値を求めることで最小の$\bf{x ^ *}$ を求める。関数$f({\bf x})$が極小である時$f({\bf x})$の導関数$f'({\bf x})$は0となる。つまり、$f'({\bf x})=0$となる$\bf{x ^ *}$を求める。
しかし、高校数学でも習うとおり、$f'({\bf x})=0$となる${\bf x}$は図1に示すとおり3通りあり得る。なので、${\bf x ^ *}$を求めるためには、さらに$f'({\bf x})$がどう変化するのかも同時に調べる必要がある。同じ$f'({\bf x})=0$となる${\bf x}$であっても、傾き$f'({\bf x})$が減少し正から負へ転じる場合は極大、符号が変化しない場合は鞍点であり、増加し負から正へと転じる場合が極小である。二次導関数$f''({\bf x})$を用いればそれぞれ、$f''({\bf x}) <0$、$f''({\bf x})=0$、$f''({\bf x})>0$の場合である。

ここで更に、極小$\neq$最小である事に注意しなければならない。図2に描いたとおり、$f'({\bf x})=0 \land f''(x) > 0$で合っても大域的に最小であるとは限らない。

以上で述べたとおりで、非線形最適化では$f'({\bf x})=0$となる${\bf x}$を求めるが、その際に傾き$f'({\bf x})$の符号と大域的にそれが最小であるかをケアしながら行うことが重要となる。非線形最適化では、後述するとおりいくつかの求解法があるが共通して探索的に${\bf x}$を微小変化させながら$f'({\bf x})=0$となる${\bf x}$を求める。どの方法も共通して、
$${\bf x}_{k+1} = {\bf x}_k + \delta {\bf x} \tag{5}$$
で表される漸化式でステップ毎に$\delta {\bf x}$を求めながら${\bf x}_k$を繰り返し更新し、収束判定を行った段階での${\bf x}_k$を解とする。この$\delta {\bf x}$をどう求めるかが方法によって異なる。
$\delta {\bf x}$を求める最も基本的な方法として最急降下(Gradient Discent)法があり、その他Newton法、Gauss-Newton (GN)法、Levenberg Marquardt(LM)法といった方法がある。どれも先述したとおり”関数$f{{\bf (x)}}$の傾き”の情報を使って$\delta {\bf x}$を求め、式(5)の漸化式によって”繰り返し”${\bf x}$を変化させながら最小値を求める。図3にそれぞれの方法の特徴についてまとめた。

勾配だけをみて更新方向・量を決めるのが勾配降下法で、最もシンプルで演算量も少なく膨大なパラメータを持つモデルにも適用出来る。昨今注目を集めているニューラルネットワークもこの勾配降下法を用いている。
ニュートン法は、勾配だけでなくグラフの形状をさらにみて更新方向・量を決める方法で勾配降下法より収束性がよい。一方で2次導関数を求める必要があって演算量が多く、また局所最適解に陥りやすいという問題がある。最小2乗問題に限定してこれらの問題を解決したのが、ガウス・ニュートン法およびレーベンバーグ・マーカート法である。
次の項からは、これらの方法について最急降下法から順に解説をしていく。
最急降下法
最急降下法のアイデアはシンプルで、傾きが減少する方向に${\bf x}$を更新し続ければ最小値を与える${\bf x}$に辿り着くはず、と考える。具体的には、各ステップ${k}$において最も$f({\bf x})$が減少する方向$\delta {\bf x}$で${\bf x}$を更新し続ける。図4(a)は最急降下法のイメージで、各ステップの${\bf x}_k$において$f({\bf x})$が減少する方向つまり勾配$f({\bf x}_k)$の符号を反転させた方向に係数$\alpha$を乗じた分だけ${\bf x}_k$を更新している。

つまり、最急降下法では式(5)の漸化式が式(6)のようになる。 $$ {\bf x}_{k+1} = {\bf x}_k - \alpha \left.\frac{\partial f}{\partial {\bf x}}\right|_{{\bf x}_{k}} \tag{6} $$ 係数$\alpha$はハイパーパラメータで、毎回の更新の度合いを決める値であり、問題毎に適当な値を設定する必要がある。最急降下法はシンプルに勾配$\left.\frac{\partial f}{\partial {\bf x}}\right|_{{\bf x}_{k}}$さえ求まれば良いという扱いやすさはあるが、大雑把に${\bf x}_k$の周りで1次の線形関数に近似して減少方向を求めているため関数の具体的な形状をあまり考慮しておらず、図4(b)のように極小点周りで振動してしまい中々収束しないという問題がある。これに対し、次に述べるNewton法では2次の項まで考慮して$\delta {\bf x}$を求めることで収束速度をより速くすることが出来ます。
Newton法
Newton法では、各ステップの${\bf x}_k$周りに$f({\bf x})$を2次の項まで含めてより正確に近似し、それを最小にし続けるように${\bf x}_k$を更新し続け、全体の最小にたどり着くという方法をとる。最急降下法と同様に傾きの方向に応じて更新方向と大きさが変わるのと同時に、各${\bf x}_k$周りの微小領域においてより関数の形状を精度良く近似し、勾配$f'({\bf x}_k+\delta {\bf x})=0$となるように更新し続けるので図5(a)のように極小値周りで振動することなく高速に極小値を求めることが出来る。

簡単のためにまず1次元の場合から具体的な式を追ってみる。${\bf x}_k$周りに$f({\bf x})$をTaylor展開すると、
$$
f(x+dx) = f(x)+f'(x)dx+\frac{1}{2}f''(x)dx^2+O(dx^3) \tag{7}
$$
となる。$O(dx^3)$を無視した上で、この左辺を最小にする$dx$は、単純に2次関数の最小値を求めるために$dx$について平方完成し、
$$
f(x+dx) = \frac{1}{2}f''(x) \left( dx+\frac{f'(x)}{f''(x)} \right) +f(x)-\frac{f'(x)^2}{f''(x)} \tag{8}
$$
となるので、漸化式(5)は式(9)のようになる。 $$ {\bf x}_{k+1} = {\bf x}_{k} - \frac{f'(x)}{f''(x)} \tag{9} $$ イメージとしては図5(a)のように各${\bf x}_k$で2次関数を近似してフィッティングしてその最小値を求めることを繰り返すのがNewton法である。平方完成してその中心を求めているだけなので、最小であるためには当然下に凸であること、即ち$f''({\bf x})>0$であることが必要となる。
一般の多次元の場合も同様で、多変数関数のTaylor展開を用いると${\bf x} \in R ^n,{\bf \delta x} \in R ^n$について
$$
\begin{align}
f({\bf x} + \delta{\bf x}) &= \sum\_{i=0} ^n \frac{1}{n!} \left ( \delta {\bf x} \cdot \nabla \right ) ^i f({\bf x}) \\\
&=f({\bf x}) + \delta {\bf x} \cdot \nabla f+\frac{1}{2} \left ( \delta {\bf x} \cdot \nabla \right ) ^2f + O(\delta {\bf x} ^3) \\\
&=f({\bf x}) + \delta {\bf x} \cdot \nabla f+\frac{1}{2}\delta {\bf x} ^T (\nabla ^2 f)\delta {\bf x} + O(\delta {\bf x} ^3)
\end{align} \tag{10}
$$
となる。 ここで、${\bf H}({\bf x})$:ヘシアン行列(Hessian Matrix)を以下で定義する。
$$
{\bf H}({\bf x}) = \begin{bmatrix}
\frac{\partial ^2 f}{\partial x_1 ^2} & \frac{\partial ^2 f}{\partial x_1 \partial x_2} & \cdots & \frac{\partial ^2 f}{\partial x_1 \partial x_n} \\
\frac{\partial ^2 f}{\partial x_2 \partial x_1} & \frac{\partial ^2 f}{\partial x_2 ^2} & \cdots & \frac{\partial ^2 f}{\partial x_2 \partial x_n} \\
\vdots & \vdots & \ddots & \vdots \\
\frac{\partial ^2 f}{\partial x_n \partial x_1} & \frac{\partial ^2 f}{\partial x_n \partial x_2} & \cdots & \frac{\partial ^2 f}{\partial x_n ^2}
\end{bmatrix} \tag{11}
$$
${\bf \delta x}$について3次以降の項を無視しヘシアン行列を用いると、$f({\bf x} + \delta{\bf x})$を${\bf x}$で展開した結果は式(12)のようになる。
$$
f({\bf x} + \delta{\bf x})=f({\bf x}) + \delta {\bf x} \cdot \nabla f+\frac{1}{2}\delta {\bf x}^T {\bf H}({\bf x}) \delta {\bf x} \tag{12}
$$
右辺を${\bf \delta x}$について微分し、極小値を与える${\bf \delta x}$を求める。*1
$$ \nabla f+\frac{1}{2}({\bf H({\bf x})}+{\bf H({\bf x}) ^T}){\bf \delta x} = {\bf 0} \tag{13} $$ ${\bf H}({\bf x})$が対称行列であり、${\bf H}({{\bf x}}) = {\bf H ^T}({{\bf x}})$であることを用いると $$ \nabla f+{\bf H({\bf x})}{\bf \delta x} = {\bf 0} \tag{14} $$ となる。よって${\bf \delta x}=-{\bf H ^{-1}({\bf x})} \nabla f$となるので、漸化式(5)は以下のようになる。 $$ {\bf x}_{k+1} = {\bf x}_{k} - {\bf H ^{-1}({\bf x}_{k})} \nabla f \tag{15} $$ 一次関数の時と同様にこの更新を繰り返すことで最小値にたどり着くためには、$f({\bf x})$が下に凸の関数であることが必要となるが、これは${\bf H}({\bf x})$が半正定値行列(positive semi-definite)であればよく、即ち $$ \delta {\bf x} ^T {\bf H}({\bf x}) \delta {\bf x} \geq 0 \tag{16} $$ であればよい。
一方でNewton法には問題点があり、ひとつは図5(b)のように局所最適解に陥りやすいという問題点がある。もう一つは、ヘシアン行列:$H({\bf x})$を求めるために計算量が大きくなってしまう点である。 非線形最小二乗法を解く場合において、後者の問題を解決したのがGauss-Newton(GN)法であり、前者の問題を解決したのがLevenberg Marquardt(LM)法である。
Gauss-Newton(GN)法
非線形最適化で扱う問題の多くは、2乗誤差の最小化つまり$f({\bf x})$が以下のようにあらわされる場合を扱うことが多い。 $$ f({\bf x})=\frac{1}{2}\sum_{i=i} ^{m} {r_i({\bf x})} ^2 \tag{17} $$ このとき勾配$\nabla f$は、 $$ \nabla f = \sum_{i=i} ^{m} {r_i({\bf x})}\frac{\partial r_i({\bf x}) }{\partial {\bf x}} \tag{18} $$ となる。ヘシアン行列:$H({\bf x})$は式(18)を更に微分することによって求めることができ、$H({\bf x})$の$(j,k)$成分を${\bf H_{jk}}$とすると、 $$ {\bf H}_{jk}=\sum_{i=i} ^{m} \left( \frac{\partial r_i }{\partial x_k} \frac{\partial r_i }{\partial x_j} + r_i \frac{\partial ^2 r_i }{\partial x_k {\partial x_j}} \tag{19} \right) $$ となる。更にここで、第2項の2階微分項を無視すると、 $$ {\bf H}_{jk}=\sum_{i=i} ^{m} \frac{\partial r_i }{\partial x_k} \frac{\partial r_i }{\partial x_j} \tag{20} $$ を得る。 ヤコビ行列${\bf J} \in {\bf R ^{m \times n}}$および残渣ベクトル${\bf r} \in {\bf R ^m}$を用いると、勾配とヘシアン行列:$H({\bf x})$はそれぞれ、 $$ \nabla f = {\bf J} ^T {\bf r} \tag{21} $$ $$ H({\bf x})={\bf J} ^T {\bf J} \tag{22} $$ となる。よって漸化式(5)は、 $$ {\bf x}_{k+1} = {\bf x}_{k} - {\bf ({\bf J} ^T {\bf J}) ^{-1}} {\bf J} ^T {\bf r} \tag{23} $$ となる。 導出過程であったとおり、GN法では2階微分項を無視するという近似を用いているため収束が保証されていない。最小値布付近で初期値を与えて、十分に小さい残差ベクトル${\bf r}$と非線形性が比較的穏やかである必要がある。
まとめ
非線形最適化についてその概要と各種法の基本と特徴についてまとめた。最急降下法とNewton法の違い、Newton法とGauss Newton法の違い、辺りがクリアに分かっていることが重要だと思う。
機械学習やコンピュータービジョンにおいて頻出の2乗誤差においては、Gauss Newton法よりもそれを改良したLevenberg Marquardt(LM)法の方が実用的には用いられる。LM法は、軽く触れた通り最急降下法とGauss Newton法を組み合わせ、双方の欠点を解決し、性能と収束性の両立を目指したものと言える。詳細はまた別のエントリーで紹介したいと思う。
ベクトルでの微分公式
はじめに
非線形最適化等を勉強していると、多次元変数$x$についてのスカラーやベクトル量の微分が登場する。毎度、何かと思い出したりするのに時間がかかり、詳細まで理解していないと気持ちが悪い性分なので備忘録も兼ねて良く登場する微分の式をまとめておきたいと思います。
スカラーのベクトル微分:
公式:
${\bf a} \in R^n$ ,${\bf A} \in R^{n \times n}$ ,${\bf x} \in R^n$
$$
\frac{\partial ({\bf a \cdot x})}{\partial {\bf x}}={\bf a} \tag{1}
$$
$$
\frac{\partial ({\bf x^T A x})}{\partial {\bf x}} = ({\bf A + A^T}) {\bf x} \tag{2}
$$
証明:
$$
\begin{align}
\frac{\partial ({\bf a \cdot x})}{\partial {\bf x}} &= \begin{pmatrix} \frac{\partial}{\partial x_1} \\ \frac{\partial}{\partial x_2} \\ \vdots \\\frac{\partial}{\partial x_n} \end{pmatrix}(a_1x_1+a_2x_2+\cdots+a_nx_n)\\\
&=\begin{pmatrix} a_1 \\ a_2 \\ \vdots \\ a_n \end{pmatrix} \\\
&={\bf a}
\end{align}
$$
$$
\begin{align}
\frac{\partial ({\bf x^T A x})}{\partial {\bf x}} &= \begin{pmatrix} \frac{\partial}{\partial x_1} \\ \frac{\partial}{\partial x_2} \\ \vdots \\\frac{\partial}{\partial x_n} \end{pmatrix} \begin{pmatrix} x_1\\x_2 \\ \vdots \\ x_n \end{pmatrix}^T \begin{pmatrix} a_{11}x_1+ a_{12}x_2\ \cdots\ +a_{1n}x_n \\a_{21}x_1+ a_{22}x_2\ \cdots\ +a_{2n}x_n \\ \vdots \ \\ a_{n1}x_1+ a_{n2}x_2\ \cdots\ +a_{nn}x_n \end{pmatrix} \\\
&=\begin{pmatrix} \frac{\partial}{\partial x_1} \\ \frac{\partial}{\partial x_2} \\ \vdots \\\frac{\partial}{\partial x_n} \end{pmatrix} (x_1\sum_{i=1}^na_{1i}x_i+x_2\sum_{i=1}^na_{2i}x_i+\cdots+x_n\sum_{i=1}^na_{ni}x_i) \\\
&=\begin{pmatrix} \frac{\partial}{\partial x_1} \\ \frac{\partial}{\partial x_2} \\ \vdots \\\frac{\partial}{\partial x_n} \end{pmatrix} (\sum_{k=1}^n\sum_{i=1}^na_{ki}x_kx_i) \\\
&=\begin{pmatrix} \sum_{k=1}^na_{k1}x_k + \sum_{i=1}^n a_{1i}x_i \\ \sum_{k=1}^na_{k2}x_k + \sum_{i=1}^n a_{2i}x_i \\
\vdots \\
\sum_{k=1}^na_{kn}x_k + \sum_{i=1}^n a_{ni}x_i \\\
\end{pmatrix} \\\
&=\begin{pmatrix} \sum_{k=1}^n(a_{k1} + a_{1k})x_1 \\ \sum_{k=1}^n(a_{k2} + a_{2k})x_2\\
\vdots \\
\sum_{k=1}^n(a_{kn} + a_{nk})x_n\\
\end{pmatrix} \\\
&=({\bf A + A^T}) {\bf x}
\end{align}
$$
ベクトルのベクトル微分:
ベクトルのベクトル微分の定義:
${\bf f} \in R^n$に対して、
$$
\frac{\partial {\bf f}}{\partial {\bf x}} =
\begin{pmatrix} \frac{\partial f_1}{\partial {\bf x_1}} \ \frac{\partial f_2}{\partial {\bf x_1}} \cdots \frac{\partial f_n}{\partial {\bf x_1}} \\
\frac{\partial f_1}{\partial {\bf x_2}} \ \frac{\partial f_2}{\partial {\bf x_2}} \cdots \frac{\partial f_n}{\partial {\bf x_2}} \\
\vdots \ \\
\frac{\partial f_1}{\partial {\bf x_n}} \ \frac{\partial f_2}{\partial {\bf x_n}} \cdots \frac{\partial f_n}{\partial {\bf x_n}}\end{pmatrix} \tag{3}
$$
公式:
${\bf A} \in R^{n \times n}$ ,${\bf x} \in R^n$
$$
\frac{\partial ({\bf A x})}{\partial {\bf x}} ={\bf A}^T \tag{4}
$$
証明:
ナブラ:$\nabla$を使って、
$$
\nabla f=\begin{pmatrix} \frac{\partial f}{\partial x_1} \\ \frac{\partial f}{\partial x_2} \\ \vdots \\ \frac{\partial f}{\partial x_n}
\end{pmatrix} \tag{5}
$$
と表す。
$$
\begin{align}
\frac{\partial ({\bf A x})}{\partial {\bf x}} &= \begin{pmatrix} \nabla \sum_{i=1}^na_{1i}x_i, \ \nabla \sum_{i=1}^na_{2i}x_i, \ \cdots \
,\nabla \sum_{i=1}^na_{ni}x_i \end{pmatrix} \\
&=\begin{pmatrix} a_{11} \ a_{21} \ \cdots \ a_{n1} \\
a_{12} \ a_{22} \ \cdots \ a_{n2} \\
\vdots \\
a_{1n} \ a_{2n} \ \cdots \ a_{nn} \\
\end{pmatrix}\\
&={\bf A}^T
\end{align}
$$
マハラノビス距離による外れ値判定
はじめに
あるデータに対して統計解析を行う際、統計的に分布から外れたデータを検知してそれを外れ値(Outlier)として扱います。
外れ値を判定するために統計的距離:マハラノビス距離はよく用いられる距離の1つです。
本エントリーでは、マハラノビス距離についてなるべく直感的に理解出来るように説明し、マハラノビス距離がカイ2乗分布に従うことを利用した外れ値判定方法についてとりあげます。
最後に、なぜマハラノビス距離がカイ2乗分布に従うのかについても説明しようと思います。
外れ値
あるデータが特定の分布に従うとします。例えば、正規分布、ポアソン分布、カイ2乗分布…何でもよいです。この時に新たなサンプルが得られたとします。このサンプルがすでに得ているデータと比べて普通なのか、異常なのかを何らかの基準で判定し、異常とみなされたものを外れ値(Outlier)と呼びます。
実験や測定を行う場合、得られたデータにノイズはつきものです。ノイズはよく正規分布に従うと仮定しますが、このときあまりに異常なデータについては、その後の解析に悪影響を及ぼすのではじきたくなります。
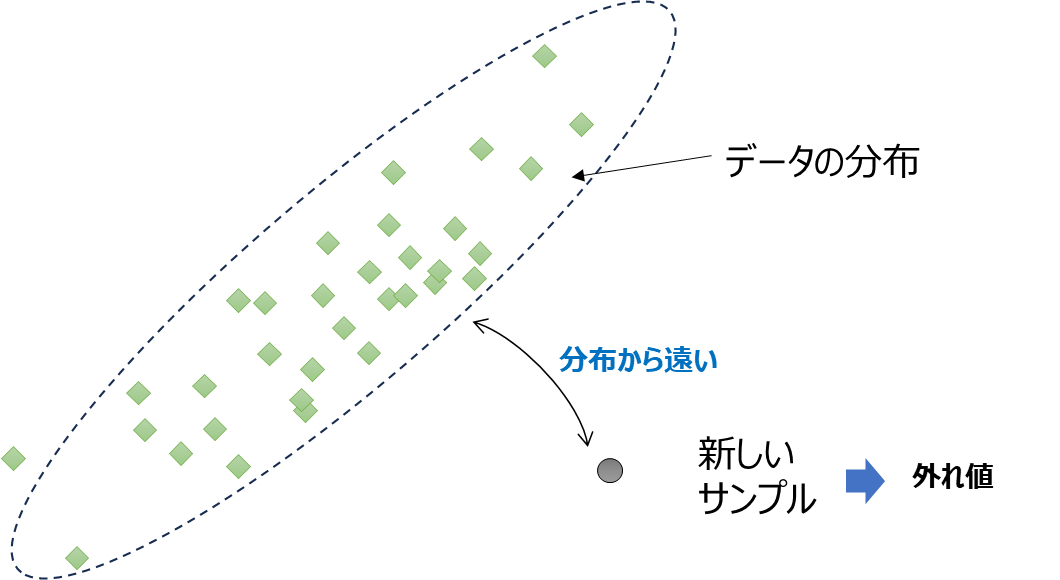
そこでデータがある分布に従うという仮定のもと、サンプルの誤差を評価してどのくらいの確率で起こるものかを計算します。そして、あまりに確率的にあり得ないのであれば、それを外れ値として統計解析には含めない、ということが実用上行われます。
この評価の方法として、よく用いられるのがマハラノビス距離です。
以降は、マハラノビス距離について解説します。
マハラノビス距離の定義
あるデータ集合の平均を${\bf \mu} \in R^n$、分散を${\bf \Sigma} \in R^{n \times n}$としたときに、あるデータ:${\bf x} \in R^n$が得られたときのマハラノビス距離:$D_M({\bf x})$は以下で定義されます。
$$
D_M({\bf x}) = \sqrt{({\bf x - \mu})^T{\bf\Sigma}^{^-1}({\bf x - \mu})} \tag{1}
$$
この式で定義されるマハラノビス距離について直感的な理解が得られるように、馴染みのあるユークリッド距離と比較しながら説明します。
直感的な理解
マハラノビス距離を使って測ることが出来るのは、データ分布に対する注目するサンプルの一貫性です。この意味について出来るだけ具体例を交えながら説明したいと思います。
分布とは何かを改めて考えると、データの集まりがどのような関係・傾向を持っているのかを示すものです。
どの辺りに集まっているのかの傾向を示す数値として平均、どのくらい散らばっているのか集まっているのかの傾向を示す数値として分散があります。
データが特定の傾向(平均、分散)の分布をなしているときにあるサンプルがその傾向に近いのか遠いのか、それが今興味のあることです。 ようは冒頭で述べた”データの分布とサンプルの一貫性”のことになります。
何かとの近さを測るには距離というものが一般に用いられます。
データの集まりとサンプルの距離を測りたかったら、データの集まりの代表である平均とそのサンプルの距離を測るのが良さそうです。
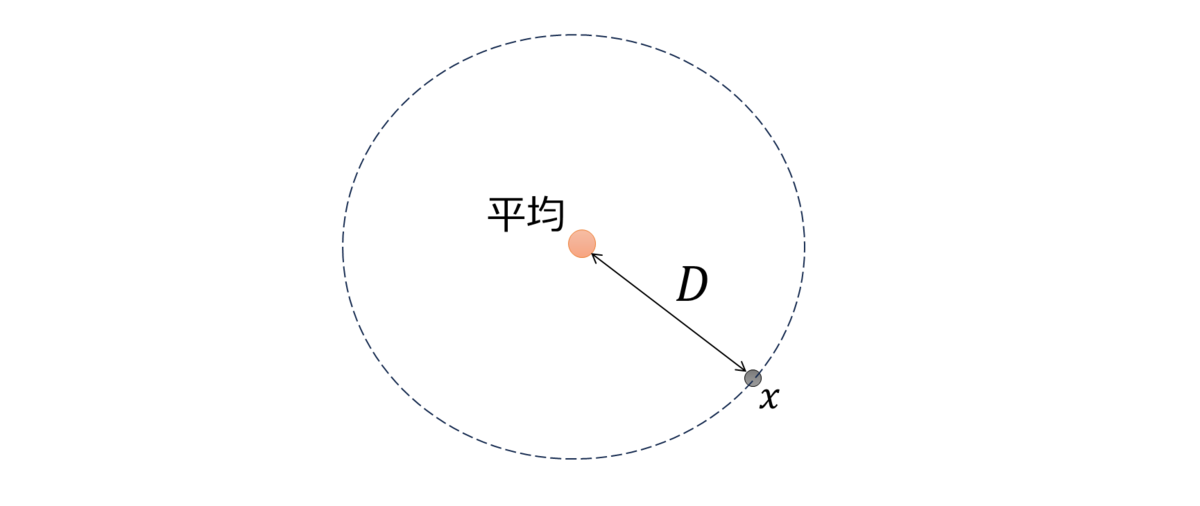
平均とサンプルの距離:$D_U({\bf x})$は以下で計算できます。
$$
\begin{align}
D_U({\bf x}) &= \sqrt{({\bf x - \mu})^T({\bf x - \mu})} \\\
&=\sqrt{(x_1-\mu_1)^2+(x_2-\mu_2)^2+\cdots+(x_3-\mu_3)^2}
\end{align} \tag{2}
$$
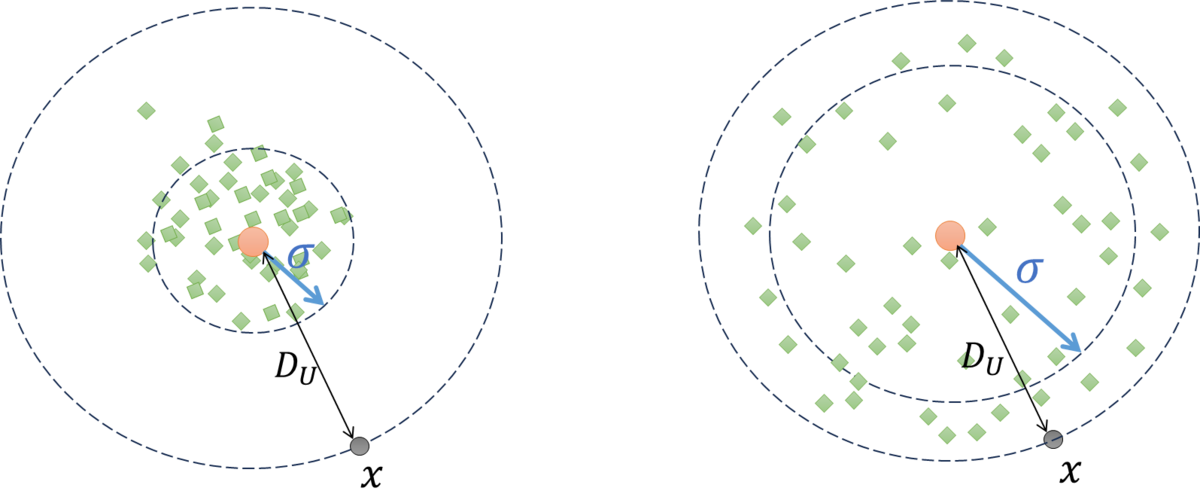
これは各要素の2乗の和のルート、つまりユークリッド距離です。 ユークリッド距離:$D_U({\bf x})$は図2の破線の円上であればサンプル${\bf x}$はどこにあっても変わりません。
一方で、データの分布も考えてみるとどうなるでしょうか。 データの分布には、各次元がどう互いに関係しているかの相関と、どのくらいの広がりがあるかの散らばり度合の2つがあります。 この両方の情報を${\Sigma}$が持っています。
先に相関についてとりあげます。
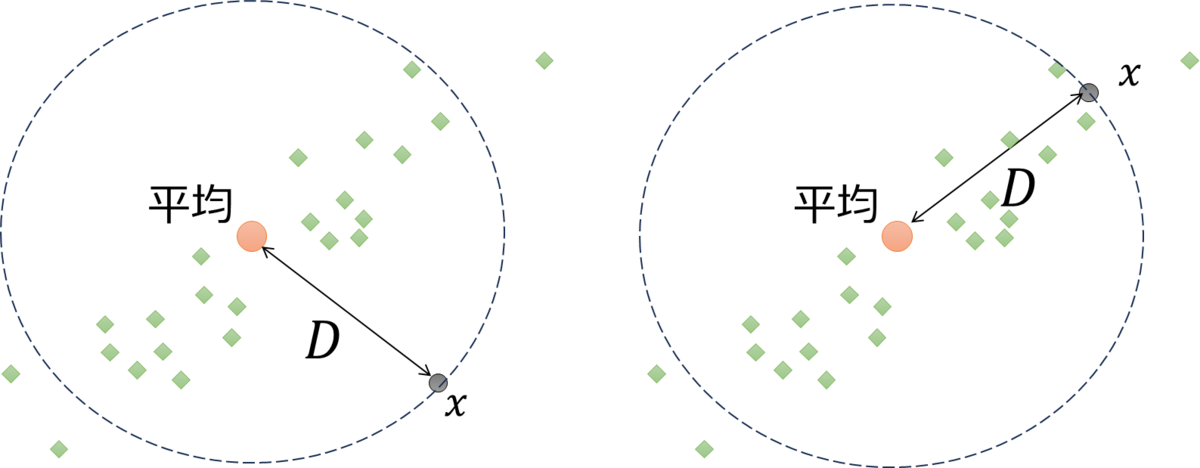
データが図3の緑の点のように分布しており、平均は赤い点の位置であるとします。 各次元は右肩上がりの相関を持った分布をしています。
どちらもユークリッド距離:$D_U({\bf x})$としては同じですが、分布への近さとしては右は近くて、左は遠い事が分かると思います。
この相関の傾向も加味した距離がまさにマハラノビス距離:$D_M({\bf x})$です。 散らばり方を表すのは分散を${\bf \Sigma}$なので、マハラノビス距離の定義式(1)には${\bf \Sigma}$が含まれます。
図3右側のように分布に整合したサンプルデータであれば$D_M({\bf x})$は小さくなり、左側のように整合していなければ大きくなるわけです。 つまり、データの次元の相関について同じ傾向を持つサンプルほど距離が近くなるということが分かります。
続いて、散らばり度合について見てみます。 仮に分布が等方的で図3のようにサンプルに隔たりがなかった場合はどうなるでしょうか。
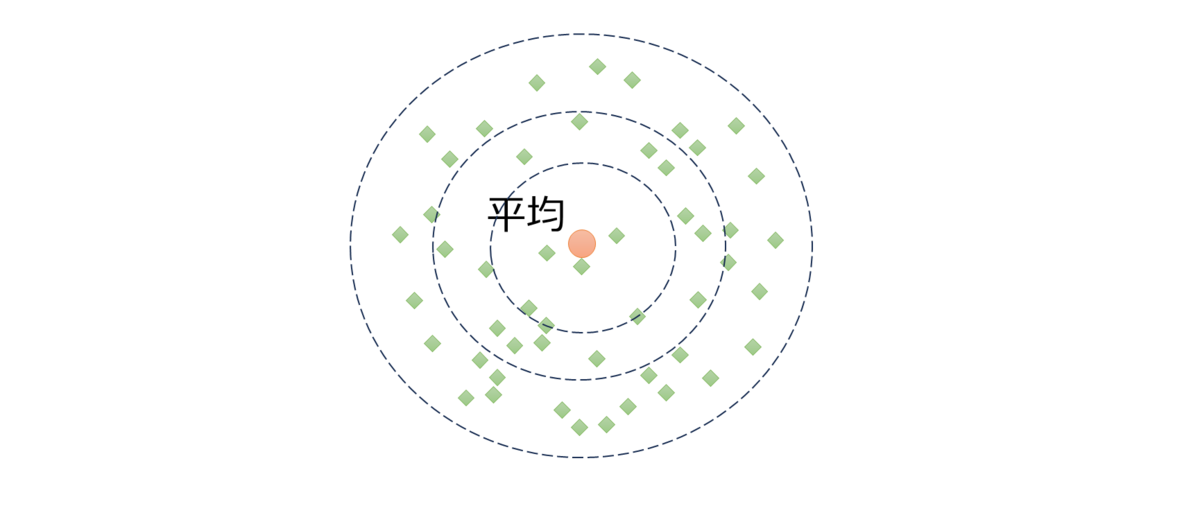
分布に隔たりがない場合、つまり相関がない場合は分散:${\bf \Sigma}$が単位行列:${\bf E}$のスカラー倍になります。
つまり、
$$
\begin{align}
{\bf \Sigma} &= \sigma^2 \begin{bmatrix} 1 & 0 & \cdots & 0 \\0 & 1 & \cdots & 0 \\ \vdots & \vdots & \ddots & \vdots \\0 & \cdots &\cdots &1 \end{bmatrix} \\\
&= \sigma^2 E
\end{align}\tag{3}
$$
これを式(1)に代入すると、
$$
\begin{align}
D_M({\bf x}) &= \frac{1}{\sigma}\sqrt{({\bf x - \mu})^T({\bf x - \mu})} \\\
&=\frac{1}{\sigma}D_U ({\bf x})
\end{align}\tag{4}
$$
となります。
つまりユークリッド距離を$1/\sigma$でスカラー倍した距離と一致することになります。 この$1/\sigma$ですが、図5を見て頂くとわかるとおり、分散は平均の周りのデータの集まり具合なので、おなじユークリッド距離でも分布との距離(マハラノビス距離)としてはデータ自体のシグマが大きければ相対的に小さくなり、小さければ大きくなるという事を意味します。
統計学の初期で習うように分散共分散行列:${\bf \Sigma}$は各次元の相関と分散の情報をもっています。
相関と分散それぞれについてユークリッド距離と比較してマハラノビス距離がどうなるかを確認しました。
分布の傾向を持った${\bf \Sigma}$を用いて式(1)のような形で距離を計算することにより、データの散らばり方を考慮した距離が計算されていることが直感的に理解できると思います。
マハラノビス距離の評価:
マハラノビス距離の概要については以上で述べたとおりですが、実用にあたってこの距離を評価する方法について次に考えます。
データの分布が正規分布に従う場合、マハラノビス距離はカイ2乗分布に従います。
正確に言うと、式(1)の定義の2乗がカイ乗分布に従います。
つまり、
$$
D_M({\bf x}) = ({\bf x - \mu})^T{\bf\Sigma}^{^-1}({\bf x - \mu}) \tag{5}
$$
で、この定義が実際はよく用いられます。
そして${\bf x} \in R^n$について${\bf x} \sim N({\bf \mu},{\bf \Sigma})$のとき、
$$
D_M({\bf x}) \sim \chi^2(n) \tag{6}
$$
となります。
なので、自由度$n$のカイ乗分布に従うことがわかれば、あとは実際に得られたマハラノビス距離が正常なのか異常なのか、統計的に判断が行えるわけです。
具体的には仮説検定の考え方を用いることが出来ます。
例えば、何かを観測しているときに過去に貯めたデータの分布に対して新しく得た観測の外れ値判定をする場合を考えます。
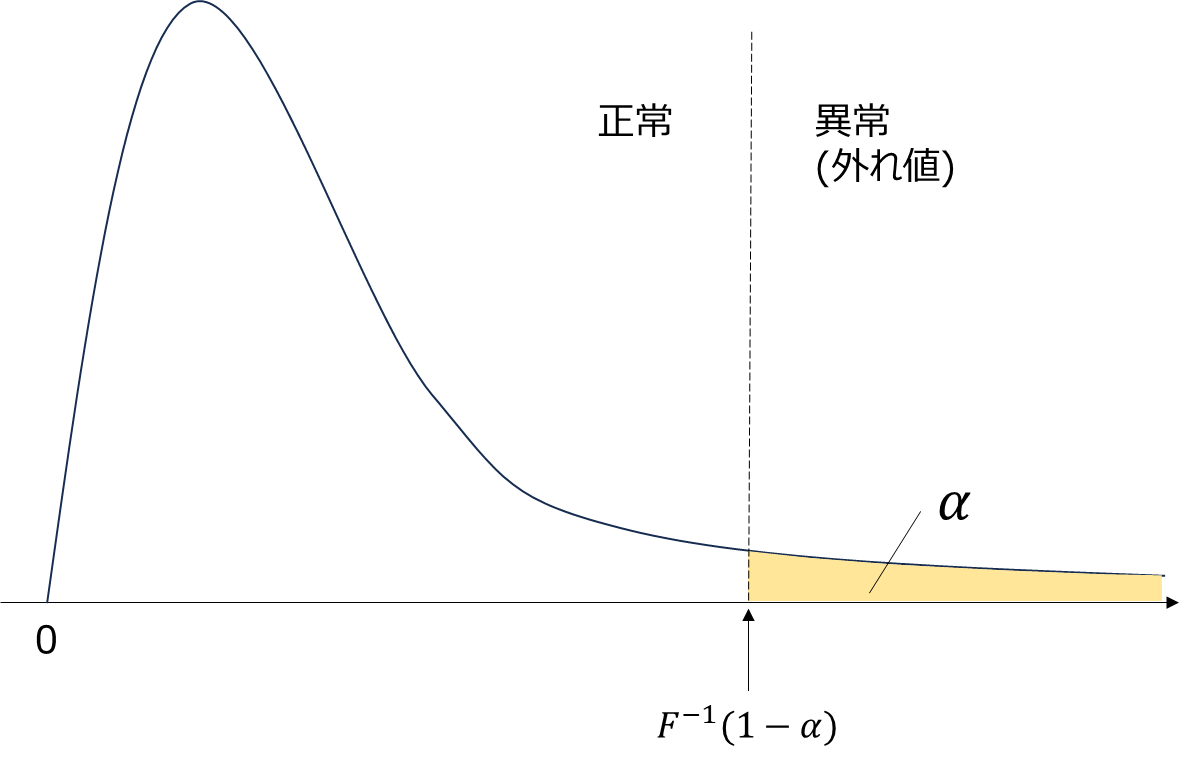
上側有意水準$\alpha$とした検定を行う場合、計算したマハラノビス距離が異常か正常かをいかの判定式によって知ることが出来ます。
$$
F_{\chi^2(n)}^{-1}(1-\alpha) < D_M({\bf x})
$$
$F_{\chi^2(n)}(y)$は自由度$n$のカイ2乗分布の分布関数です。 この式を満たす場合、${\bf x}$は外れ値と判定されます。
マハラノビス距離はなぜカイ2乗分布に従うか
マハラノビス距離がカイ2乗分布に従う理由を理解するには、正規分布の導出過程を用います。 正規分布およびカイ2乗分布については以下のエントリーでまとめています。
確率変数$Z$が標準正規分布に従うときその2乗の$Z^2$は自由度1のカイ2乗分布に従います。
つまり、
$$
Z \sim N(0,1^2) \Rightarrow Z^2 \sim \chi^2(1) \tag{8}
$$
です。 また、$n$次元の確率変数$Z$が標準正規分布に従うとき、その確立密度関数は、
$$
f({\bf z }) =\frac{1}{(2\pi)^{\frac{n}{2}}}\exp\left( -\frac{1}{2} {\bf z}^T{\bf z}\right) \tag{9}
$$
で、
$$
{\bf x} ={\bf Az}+{\bf \mu} \tag{10}
$$
という変換を用いることにより、
平均:$\mu$で分散$\Sigma$の正規分布の確立密度関数は
$$
f({\bf x})
=\frac{1}{(2\pi)^{\frac{n}{2}} \sqrt{|{\bf \Sigma}|}}\exp \left( -\frac{1}{2} ({\bf x}- {\bf \mu})^T{\bf \Sigma}^{-1}({\bf x}- {\bf \mu}) \right) \tag{11}
$$
で表すことができました。
ここで、${\bf A}$は、
$$
{\bf \Sigma} = {\bf A}{\bf A^T}\tag{12}
$$
を満たす$n \times n$の行列です。
また、
$$
\begin{align}
{\bf z}^T{\bf z} = z^2_1+z^2_2+\cdots+z^2_n\tag{13}
\end{align}
$$
カイ2乗分布の再生性を用いると$z^2_i \sim \chi^2(1)$なので、
$$
{\bf z}^T{\bf z} \sim \chi^2(n) \tag{14}
$$
になります。
式(10)を逆に用いると、
$$
{\bf z} ={\bf A}^{-1}({\bf x}- {\bf \mu}) \tag{15}
$$
となります。
これより式(12)から、
$$
\begin{align}
{\bf z}^T{\bf z} &= ({\bf A}^{-1}({\bf x}- {\bf \mu}))^T{\bf A}^{-1}({\bf x}- {\bf \mu}) \\\
&=({\bf x}- {\bf \mu})^T({\bf A}^{-1})^T{\bf A}^{-1}({\bf x}- {\bf \mu}) \\\
&=({\bf x}- {\bf \mu})^T({\bf AA^T})^{-1}({\bf x}- {\bf \mu})\\\
&=({\bf x}- {\bf \mu})^T{\bf \Sigma}^{-1}({\bf x}- {\bf \mu})
\end{align}\tag{16}
$$
となり、右辺はマハラノビス距離:$D_M({\bf x})$に等しくなります。
つまり式(14)から、
$$
({\bf x - \mu})^T{\bf\Sigma}^{^-1}({\bf x - \mu})\sim \chi^2(n) \tag{17}
$$
です。
参考文献
確率分布(2) - カイ2乗分布
はじめに
確率分布(1) - 正規分布 - Pacific19に続いて、 カイ2乗分布についてまとめます。
カイ2乗分布
一般に$n$個の確率変数:$Z_1,Z_2,Z_3,...,Z_n$が標準正規分布に従うときにその2乗の和:$X_n$つまり、
$$
X_n=\sum_{i=1}^{n} Z^2_i \tag{1}
$$
が従う分布を自由度$n$のカイ2乗分布:$\chi^2(n)$といいます。
$$
X_n \sim \chi^2(n) \tag{2}
$$
確率変数$X_n$が自由度$n$カイ2乗分布に従うときその確率密度関数は以下で表されます。 $$ f_n(x) = \frac{1}{2^{n/2}\Gamma(n/2)}x^{n/2-1}e^{-x/2} \quad (0 < x < \infty)\tag{3} $$ ここで$\Gamma$はガンマ関数と呼ばれ、以下で定義される関数です。
ガンマ関数:
$\alpha \in C, Re(\alpha) > 0$に対して
$$
\Gamma(\alpha) = \int_0^{\infty}y^{\alpha-1}e^{-y}dy \tag{4}
$$
カイ2乗分布の性質のうち重要なものとして以下の再生性と呼ばれる性質があります。
再生性:
$n \in N, m \in N$に対して、
$$
\begin{align}
X_n &\sim \chi^2(n) \\\
Y_m &\sim \chi^2(m) \\\
X_n+Y_m &\sim \chi^2(m+n)
\end{align} \tag{5}
$$
カイ2乗分布の和はまた同じ分布族のカイ2乗分布になるという、とても重要な性質です。
以下では、冒頭の標準正規分布に従う確率変数$Z$の和:式(1)が自由度$n$のカイ2乗分布に従うこと(式(2))を示します。 その証明にあたって、再生性が成り立つことを先に示します。
再生性を示す上でガンマ関数とベータ関数について知る必要があるので、一番最初にこれらをとり上げます。
ガンマ関数・ベータ関数
ガンマ関数は既にカイ2乗分布の密度関数の係数の分母に登場し、式(4)でしめしました。 このガンマ関数について重要な性質をここでは整理します。
また、もう一つベータ関数というものもとり上げます。 ベータ関数は以下で定義される2つのパラメータ$\alpha,\beta$をもつ関数です。
ベータ関数
$\alpha \in C, \beta \in C$で$Re(\alpha) > 0,Re(\beta) > 0$とする。この時ベータ関数:$B(\alpha,\beta)$は以下によって定義される。
$$
B(\alpha,\beta)=\int_0^1y^{\alpha-1}(1-y)^{\beta-1}dy \tag{6}
$$
$\alpha,\beta$は複素数で定義されていますが、対象が実数に限定される場合$\alpha > 0,\beta >0$を満たす正の実数だと思えばよいです。
ベータ関数は部分積分を使うと以下の性質を満たすことが分かります。
ベータ関数性質1:
$$
B(\alpha,\beta)=\frac{\beta-1}{\alpha}B(\alpha+1,\beta-1) \tag{7}
$$
証明:
部分積分を使って計算するだけです。
$$
\begin{align}
B(\alpha,\beta) &= \int_0^1y^{\alpha-1}(1-y)^{\beta-1}dy \\\
&=\left[ \frac{1}{\alpha}y^{\alpha}(1-y)^{\beta-1} \right]_0^{\infty}+\frac{\beta-1}{\alpha}\int_0^{\infty}y^{\alpha}(1-y)^{\beta-2}dy \\\
&=\frac{\beta-1}{\alpha}B(\alpha+1,\beta-2)
\end{align}
$$
続いてガンマ関数の性質についてです。ガンマ関数は以下の3つの性質を持ちます。
性質1:
$$
\Gamma(1) = 1 \tag{8}
$$
性質2:
$$
\Gamma \left( \frac{1}{2} \right) = \sqrt{\pi} \tag{9} \\\
$$
性質3:
$$
\Gamma(\alpha) = (\alpha-1)\Gamma(\alpha-1) \tag{10} \\\
$$
性質4:
$$
B(\alpha,\beta)=\frac{\Gamma(\alpha)\Gamma(\beta)}{\Gamma(\alpha+\beta)} \tag{11}
$$
性質1の証明:
定義に則り、計算するだけです。
$$
\begin{align}
\Gamma(1)&=\int_0^{\infty}y^{1-1}e^{-y}dy \\\
&=\left[ -e^{-y} \right]_0^{\infty} \\\
&=1
\end{align}
$$
性質2の証明:
$$
\begin{align}
\Gamma \left( \frac{1}{2} \right) &= \int_0^{\infty}y^{-\frac{1}{2}}e^{-y}dy \\\
&= \int_0^{\infty} {(t^2)}^{-1/2}e^{-t^2} \frac{\partial y }{\partial t } dt \\\
&= \int_0^{\infty} t^{-1}e^{-t^2} 2t dt \\\
&= 2 \int_0^{\infty} e^{-t^2} dt \\\
&= \sqrt{\pi}
\end{align}
$$
性質3の証明:
式(10)は部分積分を使って簡単に示すことができます。
$$
\begin{align}
\Gamma(\alpha) &= \int_0^{\infty}y^{\alpha-1}e^{-y}dy \\\
&= \left[ -y^{\alpha-1}e^{-y} \right]_0^{\infty} + (\alpha-1)\int_0^{\infty}y^{\alpha-2}e^{-y}dy \\\
&=(\alpha-1)\Gamma(\alpha-1)
\end{align} \tag{12}
$$
性質4の証明:
式(10)を繰り返し用いたうえで性質1を使うと、
$$
\begin{align}
\Gamma(\alpha) &= \int_0^{\infty}y^{\alpha-1}e^{-y}dy \\\
&=(\alpha-1)\Gamma(\alpha-1) \\\
&=(\alpha-1)(\alpha-2)\Gamma(\alpha-2) \\\
&=(\alpha-1)(\alpha-2) \cdots 2\cdot1\Gamma(1) \\\
&=(\alpha-1)(\alpha-2) \cdots 2\cdot1
\end{align} \tag{13}
$$
式(7)と式(13)の関係を繰り返し用います。
$$
\begin{align}
B(\alpha,\beta)&=\frac{\beta-1}{\alpha}B(\alpha+1,\beta-2) \\\
&=\frac{(\beta-1)(\beta-2)}{\alpha(\alpha+1)}B(\alpha+2,\beta-3) \\\
&=\frac{(\beta-1)(\beta-2)\cdots1}{\alpha(\alpha+1)\cdots(\alpha+\beta-2)}B(\alpha+\beta,1) \\\
&=\frac{(\beta-1)(\beta-2)\cdots1}{\alpha(\alpha+1)\cdots(\alpha+\beta-2)(\alpha+\beta-1)}\\\
&=\frac{\Gamma(\alpha)\Gamma(\beta)}{\Gamma(\alpha+\beta)}
\end{align}
$$
よって性質4が成り立つことが示せました。
再生性の証明
$W=X+Y$とします。$W$の確率密度関数は畳み込み積分を用いて、以下のようにあらわすことができます。
$$
f(w) = \int_0^{w}f_n(t)f_m(w-t)dt \tag{6}
$$
この式に式(3)の具体的な値を代入します。
$$
\begin{align}
f(w) &= \int_0^{w} \frac{1}{2^{n/2}\Gamma(n/2)}t^{n/2-1}e^{-t/2} \frac{1}{2^{m/2}\Gamma(m/2)}(w-t)^{m/2-1}e^{-(w-t)/2} dt \\\
&= \frac{1}{2^{(n+m)/2}\Gamma(n/2)\Gamma(m/2)}\int_0^{w}t^{n/2-1}(w-t)^{m/2-1}e^{-t/2-(w-t)/2}dt \\\
&= \frac{1}{2^{(n+m)/2}\Gamma(n/2)\Gamma(m/2)} e^{-w/2} \int_0^{w}t^{n/2-1}(w-t)^{m/2-1}dt \\\
&=\frac{1}{2^{(n+m)/2}\Gamma(n/2)\Gamma(m/2)} e^{-w/2} \int_0^{1}(wu)^{n/2-1}(w-wu)^{m/2-1} \frac{\partial t}{\partial u} du \\\
&=\frac{1}{2^{(n+m)/2}\Gamma(n/2)\Gamma(m/2)} w^{(m+n)/2-1} e^{-w/2} \int_0^{1}u^{n/2-1}(1-u)^{m/2-1} du \\\
&=\frac{B(\alpha,\beta)}{2^{(n+m)/2}\Gamma(n/2)\Gamma(m/2)} w^{(m+n)/2-1} e^{-w/2} \\\
&=\frac{1}{2^{(n+m)/2}\Gamma((m+n)/2)} w^{(m+n)/2-1} e^{-w/2}
\end{align}
$$
となり、自由度$m+n$のカイ2乗分布:$\chi^2(m+n)$の確率密度関数になっているので、式(5)の関係が成り立つことが分かります。
$Z^2 \sim \chi^2(1)$の証明:
冒頭の$X_n \sim \chi^2(n)$を示すために、まず以下を示します。
$$
Z \sim N(0,1^2) \Rightarrow Z^2 \sim \chi^2(1) \tag{*}
$$
標準正規分布の確立密度関数は以下のように書けます。
$$
f(z) = \frac{1}{\sqrt{2\pi}}e^{-\frac{1}{2}z^2} \quad (-\infty < z < \infty) \tag{1}
$$
ここで、$V=Z^2$と変数変換します。すると$V$の累積分布関数は、
$$
\begin{align}
F_v(t)&=P(v \leq t)\\\
&=P(z^2 \leq t) \\\
&=P(-\sqrt{t} \leq z \leq \sqrt{t}) \\\
&=F_z(\sqrt{t}) - F_z(-\sqrt{t})
\end{align}
$$
と書けるので、これを微分することにより、
$$
\begin{align}
f(v) &= \frac{\partial F_v(v)}{\partial v} \\\
&= \frac{\partial }{\partial v} \left( F_z(\sqrt{v}) - F_z(-\sqrt{v}) \right) \\\
&=\frac{2}{2\sqrt{v}} f(z) \\\
&=\frac{1}{\sqrt{2\pi}} v^{1/2-1} e^{-\frac{1}{2}v}
\end{align}
$$
Γ関数の性質2を用いると、
$$
\begin{align}
f(v) &= \frac{1}{2^{1/2} \Gamma(1/2)} v^{1/2-1} e^{-\frac{1}{2}v}
\end{align}
$$
となり、
これは自由度1のカイ2乗分布の密度関数となっていることが分かります。
よって(*)が示せました。
$X_n \sim \chi^2(n)$の証明:
(*)と先に示した再生性を用いることによって、帰納法で示せます。
$n=1$のとき:
(*)より明らかになり立ちます。
$n=k$のとき:
$X_k \sim \chi^2(k)$が成り立つと仮定します。
すると、
$$
X_{k+1} = X_k + Z^2_{k+1}
$$
であり、
さらに $X_k \sim \chi^2(k)$ および $Z^2_{k+1}\sim \chi^2(1)$ であるから、
再生性より、
$$
X_{k+1} \sim \chi^2(k+1)
$$
が成り立ちます。
よって任意の自然数$n$について、
$$
X_n=\sum_{i=1}^{n} Z^2_i \sim \chi^2(n)
$$
が示せました。
参考文献
- 現代数理統計学の基礎(共立講座 数学の魅力 11)(2017/4/11),久保川 達也 (著)
確率分布(1) - 正規分布
はじめに
タイトルの通り、正規分布についての記事です。最近、ベイズフィルタやカルマンフィルター、非線形最適化などを勉強していると何かと正規分布・カイ二乗分布辺りはとても頻出で、その際の式の意味を捉える際にちゃんと分布の式の成り立ちの理解が重要である事を実感したので、備忘録も兼ねてまとめたいと思います。本記事では、まず$n$次元正規分布の確率密度関数の式を導出までまとめます。
1次元の正規分布
確率変数$Z$が平均:0で標準偏差:1の正規分布$N(0, 1^2)$に従うとき、$Z$の確率密度関数:$f(z)$は以下のように書けます。
$$
f(z) = \frac{1}{\sqrt{2\pi}}e^{-\frac{1}{2}z^2} \quad (-\infty < z < \infty) \tag{1}
$$
この平均:0で標準偏差:1の場合を特に標準正規分布と言います。 一般の平均:$\mu$で標準偏差:$\sigma$の分布:$N(\mu, \sigma^2)$の確率密度関数を導くために以下の様に変数変換した確率変数$X$を考えます。
$$
x=\sigma z + \mu \tag{2}
$$
式(2)の変数変換のJacobianは、
$$
J(x \rightarrow z) = \frac{\partial z}{\partial x} = \frac{1}{\sigma} \tag{3}
$$
となります。$X$の確立密度関数:$f(x)$は、
$$
\begin{align}
f(x)&= |J(x \rightarrow z)|f(\frac{x -\mu}{\sigma}) \\\
&=\frac{1}{\sqrt{2\pi}\sigma}e^{-\frac{1}{2}(\frac{x-\mu}{\sigma})^2} \quad (-\infty < x < \infty) \tag{4}
\end{align}
$$
となります。
多次元正規分布
本エントリーのメイントピックである多次元の正規分布の確立密度関数を求めます。1次元の場合と同様に多次元版の標準正規分布の密度関数から変数変換して一般の平均と分散を持つ場合の密度関数を導出します。
$n$次元のベクトル:${\bf z} \in R^n$の各要素が独立に標準正規分布を満たすとします。
つまり${\bf z}$の要素を $$ {\bf z} = (z_1,z_2,...,z_n) $$ としたときに、 $$ z_1,z_2,...,z_n i.i.d. \sim N(0,1^2) $$ となる場合です。 この$i.i.d.$はindependently and identically distributedの略で左辺の変数が独立であることを表す記号で、統計確率の専門書を読んでいるとよくでてくるので覚えておくとよいと思います。
このときの同時分布を考えます。 独立である事から、同時分布は各の確立密度関数の積をとればよいです。また、各変数の$z_i$は標準正規分布に従うので、その確率密度関数:$f(z_i)$は式(1)で表されます。 よって、${\bf z}$の確率密度関数:$f({\bf z})$は以下のように計算できます。
$$
\begin{align}
f({\bf z }) &= \prod_{i=1}^{n}f(z_i) \\\
&=\prod_{i=1}^{n}\frac{1}{\sqrt{2\pi}}\exp \left( {-\frac{1}{2}z_i^2} \right) \\\
&=\frac{1}{(2\pi)^{\frac{n}{2}}}\exp \left( -\frac{1}{2}\sum_{i=1}^n z_i^2 \right) \\\
&=\frac{1}{(2\pi)^{\frac{n}{2}}}\exp\left( -\frac{1}{2} {\bf z}^T{\bf z}\right) \tag{5}
\end{align}
$$
一次元の場合で平均:$\mu$で標準偏差:$\sigma$で標準正規分布を変換したのと同様に多次元の場合は、正則な行列:${\bf A} \in R^{n \times n}$ と${\bf b} \in R^n$によって式(6)であらわされる変換を行います。
$$
{\bf x} ={\bf Az}+{\bf b} \tag{6}
$$
逆に${\bf z}$を${\bf x}$で表すと、正則なので逆行列が存在し、
$$
{\bf z} ={\bf A}^{-1}({\bf x}- {\bf b}) \tag{7}
$$
となります。 式(6)のJacobian行列は、
$$
\begin{align}
J({\bf x} \rightarrow {\bf z}) &= \frac{\partial {\bf z}}{\partial {\bf x}} \\
&= {\bf A}^{-1}
\end{align} \tag{8}
$$
となります。 $X$の確率分布は、
$$
\begin{align}
f({\bf x})&=|J({\bf x} \rightarrow {\bf z})|f({\bf A}^{-1}({\bf x}- {\bf b})) \\
&=|{\bf A}^{-1}|\frac{1}{(2\pi)^{\frac{n}{2}}}\exp \left( -\frac{1}{2} ({\bf A}^{-1}({\bf x}- {\bf b}))^T{\bf A}^{-1}({\bf x}- {\bf b}) \right) \\\
&=\frac{1}{(2\pi)^{\frac{n}{2}}|{\bf A}|}\exp \left( -\frac{1}{2} ({\bf x}- {\bf b})^T({\bf A}^{-1})^T{\bf A}^{-1}({\bf x}- {\bf b}) \right) \\\
&=\frac{1}{(2\pi)^{\frac{n}{2}}|{\bf A}|}\exp \left( -\frac{1}{2} ({\bf x}- {\bf b})^T({\bf A}{\bf A^T})^{-1}({\bf x}- {\bf b}) \right) \tag{9} \\\
\end{align}
$$
ここで、
$$
\begin{align}
{\bf \mu} &= {\bf b} \\\
{\bf \Sigma} &= {\bf A}{\bf A^T}
\end{align} \tag{10}
$$
とおきます。 すると、
$$
|{\bf \Sigma}|=|{\bf A}{\bf A^T}|= |{\bf A}|^2 \tag{11}
$$
なので、
$$
|{\bf A}| = \sqrt{|{\bf \Sigma}|} \tag{12}
$$
となります。式(10)と(12)を用いて式(9)を更に変形すると、
$$
f({\bf x})
=\frac{1}{(2\pi)^{\frac{n}{2}} \sqrt{|{\bf \Sigma}|}}\exp \left( -\frac{1}{2} ({\bf x}- {\bf b})^T{\bf \Sigma}^{-1}({\bf x}- {\bf b}) \right) \tag{13}
$$
$n$次元正規分布の確率密度関数が導けました。 式(10)で置いた$\mu$は平均で、$\Sigma$は分散共分散行列です。
まとめ
平均が0で分散が1の標準正規分布から一般の正規分布の確率密度関数を導く形で1次元、多次元の場合をまとめました。 式(6)のように置くことで、式(13)が導かれているという成り立ちを理解しておくと後々カイ二乗分布との関係を理解するときに役に立つと思います。
参考文献
- 現代数理統計学の基礎(共立講座 数学の魅力 11)(2017/4/11),久保川 達也 (著)
カルマンフィルター(4) - 観測の一貫性チェック(NIS)について
はじめに
本エントリーでは、カルマンフィルターで用いる観測データの一貫性チェックについて説明します。実用において観測は非常にノイジーであり、時に異常値をを含んだものとなります。そのため、外れ値をそのまま統合してしまうと状態推定が不安定になってしまう恐れがあります。そこで、毎回の更新ステップ時に得られている観測を統合すべきか否かを判断し、大きく外れた観測が得られている場合はその観測を拒否することで安定したフィルター状態を保つような仕組みが一般的に採用されています。一貫性をチェックする方法は幾つか提案がされていますが、本エントリーではその中でもひろく用いられているNormalized Innovation Squared (NIS)について具体的に解説します。
カルマンフィルターについては過去にもまとめています。
- カルマンフィルター(1) - 1次元の場合 - Pacific10
- カルマンフィルター(2) - 多次元の場合 - Pacific10
- カルマンフィルター(3) - 非線形モデルの場合(EKF, UKF) - Pacific19
観測の一貫性判定
カルマンフィルターでは、予測モデルと観測モデルの誤差が正規分布に従うという過程の下で状態量を推定します。なので誤差がのっている観測を扱うという点ではカルマンフィルターのモデルに既に織り込み済みです。しかし実用上では、仮定している正規性に従わないような外れ値的な観測が突然得られることも多く、そのような観測を全て統合してしまうと、状態推定が不安定になってしまう恐れがあります。
そこで、得られている観測の"一貫性"を確認し、一貫した観測出ない場合は統合を行わないという方法が良くとられます。 一貫性の判定手段としては、Normalized Innovation Squared (NIS)という値を用います。
状態量:${\bf y_t}$、観測:${\bf z_t}$および制御入力:観測:${\bf u_t}$とした場合の予測モデルと観測モデルは以下で表されます。
$$
\begin{align}
\bf{y_t} &= { \bf A_t y_{t-1} + B_t u_t+G_tw_t } \\
\bf{z_t} &= { \bf H_t y_t+ v_t } \\
\newline
{\bf w_t} & \sim N(0,{ \bf Q}_t) \\
{\bf v_t} & \sim N(0,{ \bf R}_t)
\end{align} \tag{1}
$$
${\bf w_t } \in R^n$と${ \bf v_t } \in R^m$は多次元正規分布に従うノイズです。各変数の意味については過去のエントリーをご参照ください。 この時の予測と更新モデルの式は以下のようになります。
予測モデル:
$$
\begin{align}
{\bf \hat{y}}_{t|t-1} &={\bf A}_t {\bf \hat{y}}_{t-1|t-1} + {\bf B}_t \bf{u_t} \\\
{\bf \Sigma}_{t|t-1} &={\bf A}_t {\bf \Sigma}_{t-1|t-1}{{\bf A}_t}^T + {\bf G}_t {\bf Q}_t {{\bf G}_t}^T
\end{align} \tag{2}
$$
更新モデル:
$$
\begin{align}
{ \bf S }&={ \bf H_t \Sigma_{t|t-1} H_t^T + R_t } \\\
{ \bf K_t } &= { \bf \Sigma_{t|t-1}H_t^T S^{-1} } \\\
{ \bf e_t } &={ \bf z}_t - { \bf H}_t { \bf \hat{y}}_{t|t-1} \\\
{ \bf \hat{y}_{t|t} } &={ \bf \hat{y}_{t|t-1} + { \bf K}_t { \bf e}_t } \\\
{ \bf \Sigma_{t|t} } &={ \bf (I -K_t H_t)\Sigma_{t|t-1} }
\end{align} \tag{3}
$$
式(3)の${\bf e}_t$をInnovation, Residualなどといい、これを判定に用います。 ${\bf e}_t$は図1に示したように、平均:${ \bf \hat{y}}_{t|t-1}$で分散:$S$の分布に従うことが分かります。NISは、過去の情報によって予測されているこの${\bf e}_t$の分布を基に今回時刻$t$に得られた観測がこの分布上あり得そうな観測なのかそうでないかを判断します。
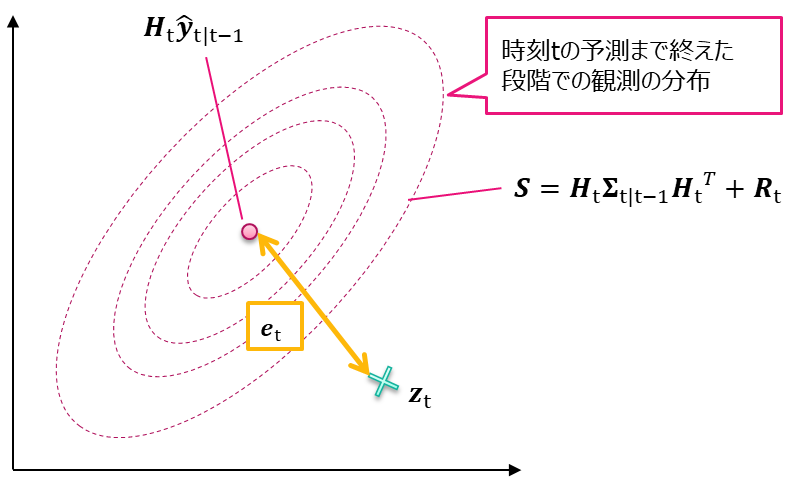
NISの定義は式(4)で表されます。
$$
NIS = {\bf e}^T_t {\bf S}^{-1}{\bf e}_t \tag{4}
$$
これは図1の分布においてのマハラノビス距離(Mahalanobis' distance)に他なりません。マハラノビス距離は、過去に対する現在のデータの一貫性を確認する方法として教師なし学習での異常検知等によく用いられます。カルマンフィルターの観測においては、平均:${ \bf \hat{y}}_{t|t-1}$で分散:$S$が時刻$t-1$までの状態と時刻$t$の予測によって決まっているという点が重要で、今回時刻$t$に得られた観測データがその分布に適合するかをみて異常か正常かを判断します。
ここでマハラノビス距離がカイ2乗分布に従うことを利用して、判断の基準としてはカイ2乗検定の考え方を用いることが出来ます。 マハラノビス距離がカイ2乗分布に従う理由は、こちらのエントリーでまとめています。
カルマンフィルターの観測においては、特定の有意水準を設定しNISが棄却域である場合は異常と判断し式(3)の更新モデルの平均と分散の更新式をスキップするということを行います。
まとめ
カルマンフィルターを実用する上で重要となるNISについて解説しました。NISにより、過去と現在の観測の一貫性をチェックしながらの観測情報の扱いが可能になり、外れ値的な観測を拒否することによって安定な状態推定が出来るようになります。
参考文献
カルマンフィルター(3) - 非線形モデルの場合(EKF, UKF)
はじめに
カルマンフィルター(1),(2)に続いて本エントリーでは、非線形なモデルに対してカルマンフィルターを用いるための方法についてまとめます。本稿で述べる内容については、線形モデルの場合のカルマンフィルターの理解を前提とします。線形モデルの場合のカルマンフィルターについては、過去にまとめておりますのでこちらも是非ご覧下さい。
具体的には、非線形モデルを線形近似する拡張カルマンフィルター(Extended Kalman FIlter : EKF)およびサンプル点を用いて分布を近似する無香カルマンフィルター(Unscented Kalman Filter:UKF)について紹介します。EKFの解説については、日本語の記事もネット上に豊富なので本記事ではどちらかというとUKFの解説に重きを置きたいと思います。
非線形なモデル
以前のエントリーで紹介したとおり、一般のカルマンフィルターでは予測モデルと更新モデルの両方が状態量と制御入力、観測に対して線形のモデルである事を前提に時刻$t$における平均と分散およびカルマンゲインを求める式を導出することが出来ました。ここでは線形でないモデルを考えて、その場合の平均と分散およびカルマンゲインを求める式を導出します。
非線形モデル:
$$
{\bf y_t}=f({\bf y_{t-1}},{ \bf u}_t)+{\bf G}_t{ \bf w}_t \tag{1}
$$
$$
{\bf z}_t=g({ \bf y}_t)+{ \bf v}_t \tag{2}
$$
$$
\begin{align}
{ \bf w}_t & \sim N(0,Q_t) \tag{3} \\\
{ \bf v}_t & \sim N(0,R_t) \tag{4}
\end{align}
$$
ここで、$\bf{u_t}$は制御入力、${ \bf G}_t$はノイズのモデル式で${ \bf w}_t$と${ \bf v}_t$はそれぞれ式(3),(4)の通り分散共分散行列がそれぞれ$Q_t$と$R_t$の多正規分布に従うノイズです。また、$\bf{y_t},\bf{z_t},\bf{u_t}$と${ \bf w}_t$と${ \bf v}_t$および${ \bf w}_t$と${ \bf v}_t$同士はtによらず独立であるとします。
EKF
EKFのアイデアはシンプルで、非線形な(1)と(2)も局所的に見ると線形な関数と近似できるのでその近似式さえ求まれば後は通常のKFと同様に扱えるというものです。数学的にはTaylor展開した上で、2次の項以降を無視します。
式(1)・(2)の線形化:
式(1)と(2)において$f(\bf{y_{t-1}},\bf{u_t})$と$g(\bf{y_{t}})$を$\bf{\hat{y}_{t-1|t-1}}$の周りでTaylor展開し、2次の項移行を無視します。
$$
\begin{align}
{\bf y}_t&=f({ \bf y}_{t-1},{\bf u}_t) \\\
&=f({\bf \hat{y}}_{t-1|t-1},{\bf u_t})+{ \bf F}_t({ \bf y}_{t-1} - {\bf \hat{y}}_{t-1|t-1}) \tag{5}
\newline
\newline
{\bf z_t}&=g({\bf y}_t) \\\
&=g({ \bf \hat{y}}_{t|t-1}) + { \bf H}_t({ \bf y}_t-{ \bf \hat{y}}_{t|t-1}) \tag{6}
\end{align}
$$
ここで${ \bf F_t,H_t }$はJacobianであり、以下で表されます。
$$
\begin{align}
{ \bf F_t } &= \left.\frac{\partial f}{\partial \bf{y}}\right|_{\bf{y}=\bf{\hat{y}}_{t-1|t-1},\bf{u_t}} \tag{7}
\newline
\newline
{ \bf H_t } &= \left.\frac{\partial g}{\partial \bf{y}}\right|_{\bf{y}=\bf{\hat{y}}_{t|t-1}} \tag{8}
\end{align}
$$
この関係式を用いて以下は予測モデルと更新モデルの期待値と分散の式を導出します。考え方は線形の場合と同様です。時刻:$t$において得られている情報:$I_t$を使って条件付き確率の期待値・分散として計算します。
予測モデル:
$$
\begin{align}
{\bf \hat{y}_{t|t-1} } &= E[{ \bf y_t }| I_{t-1},{ \bf u_t }] \\\
&= E[f({ \bf \hat{y}_{t-1|t-1} },{\bf u_t })+{ \bf F}_t({\bf y_{t-1} } - { \bf \hat{y} }_{t-1|t-1}) + { \bf G_t } { \bf w_t }| I_{t-1},{ \bf u_t}]\\\
&= E[f({ \bf \hat{y}_{t-1|t-1} },{ \bf u_t })| I_{t-1},{ \bf u_t }]+E[{ \bf F}_t({ \bf y_{t-1}} - { \bf \hat{y}}_{t-1|t-1}) | I_{t-1},{ \bf u_t}] + E[{ \bf G_t }{ \bf w_t } | I_{t-1},{ \bf u_t }]\\\
&= f({ \bf \hat{y}_{t-1|t-1}},{ \bf u_t })+{ \bf F}_t({ \bf \hat{y}}_{t-1|t-1} - { \bf \hat{y}}_{t-1|t-1}) \\\
&= f({ \bf \hat{y}_{t-1|t-1}},{ \bf u_t }) \tag{9}
\newline
\newline
{ \bf \Sigma_{t|t-1}} &= Var[{ \bf y_t }|I_{t-1},{\bf u_t }] \\\
&= Var[f({ \bf \hat{y}_{t-1|t-1}},{ \bf u_t })+{ \bf F}_t({ \bf y_{t-1}} - { \bf \hat{y}}_{t-1|t-1})+ { \bf G_t }{ \bf w_t } | I_{t-1},{ \bf u_t }]\\\
&= Var[f({ \bf \hat{y}_{t-1|t-1} },{\bf u_t })| I_{t-1},{ \bf u_t }]+Var[{ \bf F}_t({ \bf y_{t-1} } - { \bf \hat{y}}_{t-1|t-1})| I_{t-1},{ \bf u_t }]+ Var[{ \bf G_t }{ \bf w_t } | I_{t-1},{ \bf u_t }] \\\
&=Var[{ \bf F}_t{ \bf y_{t-1} }| I_{t-1},{ \bf u_t }]+{\bf{G_tQ_tG^T_t}} \\\
&={\bf F_t \Sigma_{t-1|t-1} F^T_t}+{\bf{G_tQ_tG^T_t}} \tag{10}
\end{align}
$$
更新モデル:
$$
\begin{align}
{\bf \hat{y}}_{t|t}&=E[{ \bf y_t }|I_{t}] \\\
&= E[{ \bf y_t }|I_{t-1},{ \bf z_t}]\\\
&= E[{ \bf y_{t|t-1} }|{ \bf z_t}]\\\
&= {\bf \hat{y}}_{t|t-1} + {\bf CS^{-1}}({\bf z}_t - g({\bf y_t})) \\\
&={\bf \hat{y}}_{t|t-1} + {\bf K }_t({\bf z}_t - g({\bf y_t})) \tag{11}
\newline
\newline
{\bf \Sigma}_{t|t} &= Var[\bf{y}_t|I_t] \\\
&= Var[{ \bf y_t }|I_{t-1},{ \bf z_t}]\\\
&= Var[{ \bf y_{t|t-1} }|{ \bf z_t}]\\\
&= {\bf \Sigma}_{t|t-1} - \bf{\Sigma}_{t|t-1}H_t^TS^{-1}H_t{\bf \Sigma}_{t|t-1} \\\
& ={\bf (I -K_t H_t) \Sigma}_{t|t-1} \tag{12}
\\\newline
K_t &= {\bf \Sigma}_{t|t-1}{ \bf H}_t^T { \bf S}^{-1} \tag{13}
\end{align}
$$
ここで${ \bf C,S}$は以下で表される。これも線形の場合と変わりません。
$$
\begin{align}
C &=Cov(\bf{y}_{t|t-1},\bf{z}_t) \\\
&=Cov(\bf{y}_{t|t-1},H_t\bf{y}_{t|t-1}+ v_t) \\\
&=E[(\bf{y}_{t|t-1} - \bf{\hat{y}}_{t|t-1})(H_t\bf{y}_{t|t-1} - H_t\bf{\hat{y}}_{t|t-1})^T] \\\
&=E[(\bf{y}_{t|t-1} - \bf{\hat{y}}_{t|t-1})(\bf{y}_{t|t-1} -\bf{\hat{y}}_{t|t-1})^TH_t^T] \\\
&=E[(\bf{y}_{t|t-1} - \bf{\hat{y}}_{t|t-1})(\bf{y}_{t|t-1} -\bf{\hat{y}}_{t|t-1})^T]H_t^T \\\
&={\bf \Sigma}_{t|t-1}{ \bf H}_t^T \tag{14} \\\
\newline
S&= Var({\bf z}_t) \\\
&= Var( { \bf H}_t \bf{y}_{t|t-1}+{ \bf v}_t) \\\
&={ \bf H}_t { \bf \Sigma}_{t|t-1} { \bf H}_t ^T + { \bf R}_t \tag{15}
\end{align}
$$
以上まとめるとEKFの予測・更新の式は以下の様になります。
予測:
$$
\begin{align}
{\bf \hat{y}_{t|t-1} }& = f({ \bf \hat{y}_{t-1|t-1}},{ \bf u_t })\\\
{ \bf \Sigma_{t|t-1}} &= {\bf F_t \Sigma_{t-1|t-1} F^T_t}+{\bf{G_tQ_tG^T_t}}
\end{align}
$$
更新:
$$
\begin{align}
{\bf C } &= { \bf \Sigma}_{t|t-1}{ \bf H}_t^T \\\
{\bf S } &= { \bf H}_t { \bf \Sigma}_{t|t-1} { \bf H}_t^T + { \bf R}_t \\\
{ \bf K}_t &= \bf{\Sigma}_{t|t-1}H_t^T S^{-1} \\\
\newline
{\bf \hat{y}}_{t|t}&={\bf \hat{y}}_{t|t-1} + {\bf K }_t({\bf z}_t - g({\bf y_t})) \\\
{\bf \Sigma}_{t|t} &= ({ \bf I} -{ \bf K}_t { \bf H}_t){ \bf\Sigma}_{t|t-1}
\end{align}
$$
但し、
$$
\begin{align}
{ \bf F_t } &= \left.\frac{\partial f}{\partial \bf{y}}\right|_{\bf{y}=\bf{\hat{y}}_{t-1|t-1},\bf{u_t}}
\newline
\newline
{ \bf H_t } &= \left.\frac{\partial g}{\partial \bf{y}}\right|_{\bf{y}=\bf{\hat{y}}_{t|t-1}}
\end{align}
$$
UKF
EKFの課題として、線形化する一点のみの局所的な傾きの情報のみで変換後の分布を決めてしまうので、非線形性が強い場合誤差が大きくなってしまうという課題があります。そこで提案されたのがUKFでEKFと異なり一点のみではなくシグマ点という複数の点を抽出し、それらすべてを使って変換後の分布を求めます(図1)。
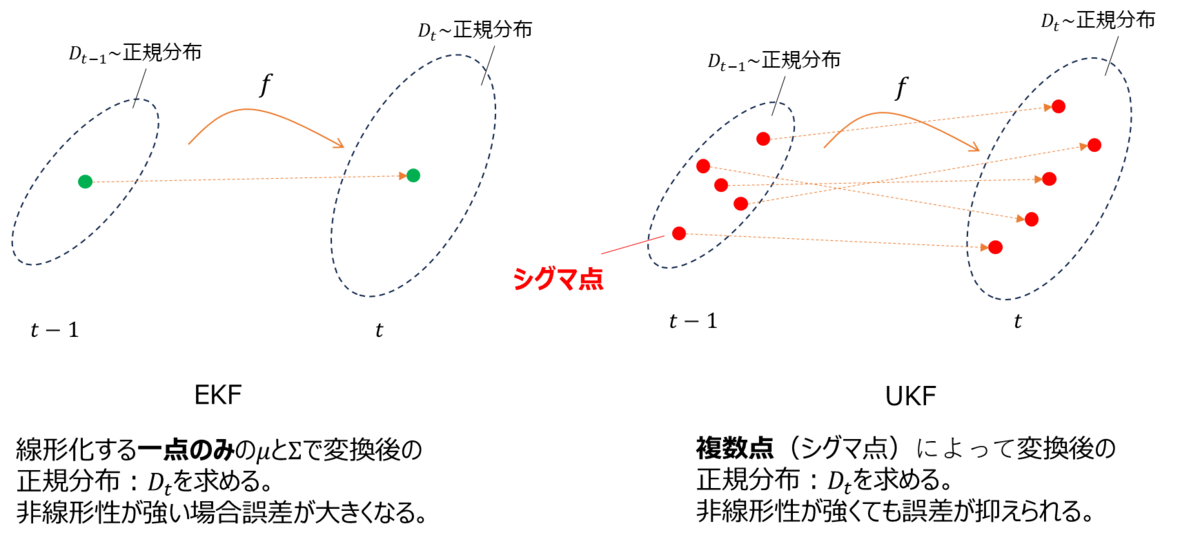
EKFは非線形変換を式(7),(8)で表したように更新前の状態量の周辺でTyalor展開して近似しました。これは図1の左側のように更新前の状態量一点の傾きのみで決まる変換が分布:$D_{t-1}$全体に適用されると仮定し、変換後の分布:$D_t$を計算します。しかし変換:$f$の非線形性が強い場合は展開した一点に適用される線形変換が分布:$D_{t-1}$のずれた点に対しては適用できず誤差が大きくなってしまうという問題が発生します。
そこでUKFでは決まったルールに則って抽出したサンプル複数個を$f$によって先に変換し、そのそれぞれの変換後の値を使って変換後の分布:$D_t$を求めます。この決まったルールによって抽出されたサンプル点を”シグマ点”といいます。非線形変換によって変換された点は正規分布には必ずしも従わないのですが、UKFでは変換後のシグマ点がもっとも従う正規分布を求めることで変換後の分布:$D_t$を決定します。
また、変換後のシグマ点を使って$D_t$を決定する際にすべてを等価に扱うわけではなく一般に中心に近いほど重みを付けて求めます。$D_t$を近似する際に注目する点により重みを付けた近似を行うことは自然な発想かと思います。 以下では、このシグマ点の抽出方法と重みについてと分布:$D_t$の導出手順について述べます。
シグマ点の抽出方法:
シグマ点の設定方法は無数に考えることができますが、その中でもより情報量が高くかつ満遍ない抽出方法を考えます。まずEKFでも代表点としている分布の平均点は含めるべき点であることは直感的にわかります。さらに平均点を中心に標準偏差の定数倍にした点を抽出します。分布を代表する方向を$L$個求めて図2のように各方向の+と-の方向にシグマ点を設定します。図2は$L=2$で合計5つのシグマ点を設定する例です。
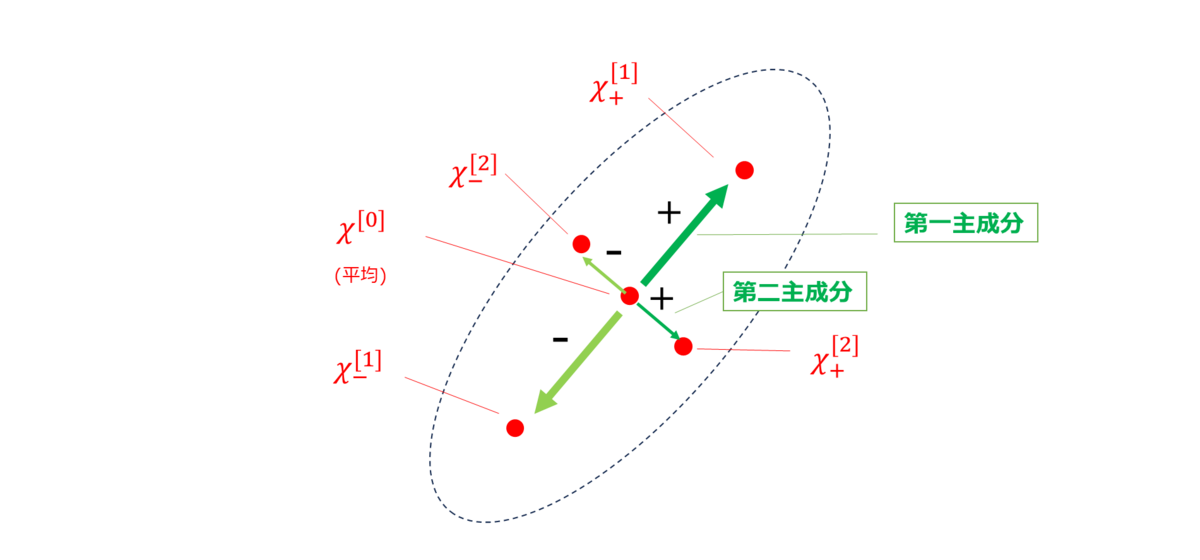
一般に$L$個の方向でシグマ点をを取る場合に、$i=1,2,3,...,L$番目の方向のシグマ点:$\chi^{[i]}$は以下で表すことができます。
$$
\begin{align}
{\bf \chi}^{[0]}&={\bf \mu} \\\
{\bf \chi}_{+}^{[i]}&={ \bf \mu} +(\sqrt{(L+\lambda){\bf \Sigma }})_i \quad (i=1,2,3,...,L) \\\
{\bf \chi}_{-}^{[i]}&={ \bf \mu} -(\sqrt{(L+\lambda){\bf \Sigma }})_{i-L} \quad (i=L+1,L+2,L+3,...,2L)
\end{align} \tag{16}
$$
ここで${\bf \mu}$は平均点であり、$(\sqrt{(L+\lambda){\bf \Sigma }})_i$は以前のエントリーでも述べた対角化によって以下のように${ \bf U}$と${ \bf D}$に分解した行列の第$i$列です。
$$
\begin{align}
{\bf \Sigma} &={\bf U D U^T} \\\
&={\bf U }\begin{bmatrix} d_{11} & \cdots & 0 \\\
0 & \ddots & 0 \\\
0 & \cdots & d_{nn}
\end{bmatrix} {\bf U }^T \\\
&={\bf U }\begin{bmatrix} \sqrt{d_{11}} & \cdots & 0 \\\
0 & \ddots & 0 \\\
0 & \cdots & \sqrt{d_{nn}}
\end{bmatrix} \begin{bmatrix} \sqrt{d_{11}} & \cdots & 0 \\\
0 & \ddots & 0 \\\
0 & \cdots & \sqrt{d_{nn}}
\end{bmatrix} {\bf U }^T \\\
&={ \bf U \sqrt{D} \sqrt{D}^T U^T } \tag{17}
\newline
\newline
{ \bf \sqrt{\Sigma}} &= { \bf U \sqrt{D}} \tag{18}
\end{align}
$$
なので、$(\sqrt{(L+\lambda){\bf \Sigma }})_i$は上記式(17)・(18)によって導き出される${ \bf \sqrt{\Sigma}}$にスカラー倍の係数:$\sqrt{(L+\lambda)}$をかけたものになります。ここで$\lambda$は調整パラメータになります。
ところで、シグマ点を抽出するうえでは元の分布:$D_{t-1}$をなるべく代表する点を選びたいという目的がありました。そのために分布の拡がりがある方向に点をとっていくという方法をとります。これは主成分分析(Principle Component Analysis:PCA)において分散共分散行列を対角化することで主成分を求める手順にほかならず、それは式(17)そのものになります。なので、式(17)に登場する$\sqrt{D}$の成分を大きい順に並び変え、第1,2,...,L主成分の固有ベクトルこそが第$i$方向のシグマ点${\bf \chi}_{+}^{[i]},{\bf \chi}_{-}^{[i]}$の方向となる。
この変換された$2L+1$この点:${\bf \chi^{[0]}, \chi}_{+}^{[i]},{\bf \chi}_{-}^{[i]}$に重みを付けて平均と分散は以下のように計算されます。
$$
\begin{align}
{\bf \mu'} &= \sum_{n=0}^{2L} w_m^{[i]}g({\bf \chi^{[i]}})\tag{19} \\\
{\bf \Sigma' }
&= \sum_{n=1}^{2L} w_c^{[i]}(g({\bf \chi^{[i]}}) - { \bf \mu'})(g({\bf \chi^{[i]}}) - { \bf \mu'})^T \tag{20}
\end{align}
$$
ここで、$w_m^{[i]}$と$w_c^{[i]}$はそれぞれ平均と分散を求めるための合計が1となるような重み係数で以下のような式で表されます。これらの具体的な式の導出については本稿では割愛させて頂きますが、詳しくは参考文献[2]でも述べられているのでこちらを参照してください。
$$
\begin{align}
w_m^{[0]} &= \frac{\lambda}{L + \lambda} \\\
w_c^{[0]} &= w_m^{[0]}-(1-\alpha^2+\beta) \\\
w_m^{[i]} &= w_c^{[i]} = \frac{1}{2(L + \lambda)} (i=1,2,3,...,L)
\end{align} \tag{21}
$$
式(21)で$\alpha$と$\beta$は調整パラメータです。 以下でこれらの関係を用いた予測と更新の手続きでは、(17)と(18)式で抽出方向を求めたうえでシグマ点を決定し、式(21)で決定される重みを用いて式(19)と(20)で平均と分散を求めることを行います。
予測: 予測のステップ、つまり${\bf y_{t-1|t-1}}$から${\bf y_{t|t-1}}$を求める手順を整理します。なので、再帰的手続きによって${\bf \hat{y}_{t|t-1} }$と${ \bf \Sigma_{t|t-1}}$は求まっているものとします。 この下で式(17)と(18)のPCAの手続きによって抽出されたシグマ点を$s_i(i=1,2,3,...,2L+1)$とします。この時に式(1)の非線形関数$f$によって変換された点を$y_i$とします。
$$
{\bf y}_i = f({\bf s}_i) \quad (i=0,2,3,...,2L) \tag{22}
$$
よって式(19)と(20)を用いることにより平均と分散は、
$$
\begin{align}
{\bf \hat{y}}_{t|t-1} &= \sum_{i=0}^{2L} w_m^{[i]}{\bf y}_i \tag{23}\\\
{\bf \Sigma}_{t|t-1} &= \sum_{i=0}^{2L} w_c^{[i]}({\bf y}_i-{\bf \hat{y}}_{t|t-1})({\bf y}_i-{\bf \hat{y}}_{t|t-1})^T + {\bf{G_tQ_tG^T_t}}\tag{24}
\end{align}
$$
で求めることができます。
更新: 式(23)と(24)によって予測の${\bf \hat{y}}_{t|t-1}$と${\bf \Sigma}_{t|t-1}$が求まったのでこれからの更新の計算式を導出します。 予測と同様に、抽出されたシグマ点を$s_i(i=1,2,3,...,2L+1)$の式(2)の非線形関数$g$によって変換された点を$z_i$とします。
$$
{\bf z}_i = g({\bf s}_i) \quad (i=0,2,3,...,2L) \tag{25}
$$
以前のエントリーでも述べたように、多変正規分布の条件付確率$X1|X2$はそれぞれの平均と共分散行列を用いて以下のようになります。
$$
X_1|X_2 \sim N(\mu_1 + \Sigma_{12} \Sigma_{22}^{-1} ({\bf x_2}-{\bf \mu_2}), \Sigma_{11} -\Sigma_{12}\Sigma_{22}^{-1}{\Sigma_{12}}^T) \tag{26}
$$
なので今求めたい${\bf y}_{t|t-1}|{\bf z}$はこの関係を使うことにより、式(27)-(32)で求める事が出来ます。
$$
\begin{align}
{\bf \hat{z} } &= \sum_{i=0}^{2L} w_m^{[i]}{\bf z}_i \tag{27}\\\
{\bf S } &= \sum_{i=0}^{2L} w_c^{[i]}({\bf z}_i- {\bf \hat{z} })({\bf z}_i -{\bf \hat{z} })^T + {\bf R}_t \tag{28} \\\
{\bf C } &= \sum_{i=0}^{2L} w_c^{[i]}({\bf s}_i- {\bf \hat{y}_{t|t-1} })({\bf z}_i -{\bf \hat{z} })^T \tag{29} \\\
{\bf K}_t &= {\bf C } {\bf S }^{-1} \tag{30} \\\
{\bf \hat{y}}_{t|t} &= {\bf \hat{y}}_{t|t-1} + {\bf K}_t({\bf z} - {\bf \hat{z} } ) \tag{31}\\\
{\bf \Sigma}_{t|t-1} &= {\bf \Sigma}_{t-1|t-1} - {\bf K_tSK_t^T} \tag{32}
\end{align}
$$
まとめ
非線形なモデルに対してカルマンフィルターを用いるための方法についてEKFとUKFについて説明しました。一般に非線形性が強い場合にはUKFが性能が良いとされています。 理論ばかりつらつらと説明してしまったので、次回のエントリーは今回までに説明したカルマンフィルターについて簡単なサンプルを実装してEKFやUKFの性能差を調べてみたいと思います。
参考記事
- カルマンフィルター過去解説記事
参考文献
[1] https://en.wikipedia.org/wiki/Kalman_filter
[2] "UKF(Unscented Kalman FIlter)って何?",(https://www.jstage.jst.go.jp/article/isciesci/50/7/50_KJ00004329717/_article/-char/ja/)
